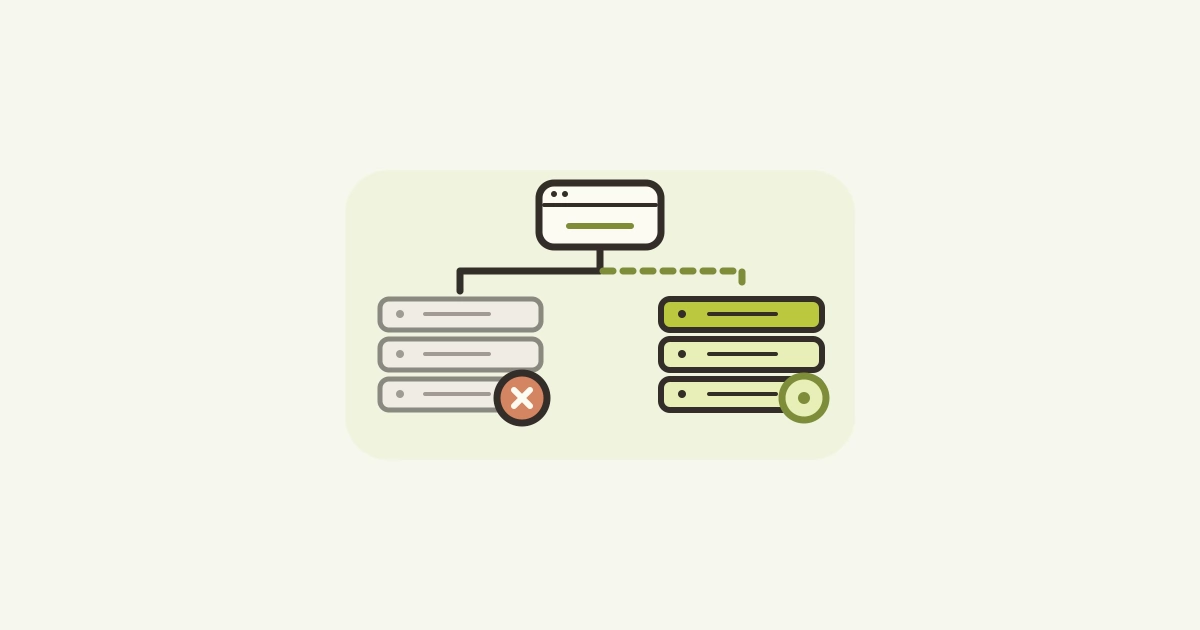
운영 서버 한 대가 꺼졌다고 가정해 보겠습니다. 두 번째 서버에서 앱이 떠 있어도 사용자가 쓰던 주소가 그 서버로 향하고, 앱이 기존 데이터를 읽고 새 데이터를 저장할 수 있어야 서비스가 돌아옵니다. 얼쑤에서는 서버 두 대를 유지하고 추가 유료 인프라를 전제하지 않는 조건으로 Docker Compose를 확장하는 안과 가벼운 Kubernetes 배포판인 K3s를 쓰는 안을 비교했습니다. 비교 기준은 각 도구가 앱 실행, 접속, 쓰기 복구 중 어디까지 맡을 수 있는가였습니다.
정상 배포와 서버 전체 장애
10월 검토 당시 웹 입구와 백엔드, MySQL 컨테이너는 한 서버에 모여 있었습니다. 정상 배포에서는 그 서버가 살아 있습니다. 기존 백엔드 옆에 새 버전을 먼저 띄우고, 준비 상태를 확인한 뒤 웹 입구가 새 요청을 넘길 대상을 바꿀 수 있습니다. 기존 요청을 끝낼 때까지 이전 버전을 남겨 두는 블루그린 배포입니다. 익숙한 Compose를 확장하는 안을 먼저 검토하자는 권고는 여기서 나왔습니다. 새 배포 도구로 옮기지 않아도 이 문제를 줄일 방법이 있었기 때문입니다. 얼쑤의 Compose 블루그린 배포
서버 전체가 사라지면 조건이 달라집니다. 그 위의 두 백엔드와 사용자 요청을 받아 주던 입구, 쓰기를 받던 DB가 함께 영향을 받습니다. 두 번째 서버에서 앱을 켤 수 있어도, 사용자의 주소가 살아 있는 쪽으로 향해야 하고 앱은 쓰기를 안전하게 이어 갈 DB에 연결해야 합니다. 이미 저장된 녹음을 읽을 수 있는지도 확인해야 합니다. 검토에서는 실패한 지점에 따라 앱 실행, 사용자 접속, 데이터 복구를 따로 비교했습니다.
| 상황 | 필요한 것 | 성공을 판단할 수 있는 관측 |
|---|---|---|
| 정상 배포로 앱 버전을 바꾼다 | 새 버전 준비 검사, 연결 전환, 이전 요청의 완료 | 전환 전후 대표 요청과 진행 중이던 작업이 끝난다. |
| 운영 서버 한 대를 잃는다 | 살아 있는 앱, 접속 전환, 안전한 DB 쓰기 경로와 파일 접근 | 같은 사용자 주소에서 읽기와 쓰기가 다시 성공한다. |
| 삭제나 데이터 손상 이전으로 돌아간다 | 되돌아갈 유효한 백업 사본과 복원 절차 | 격리 환경에서 데이터를 복원하고 필요한 내용과 앱 동작을 확인한다. |
두 번째 서버에서 확인한 세 가지
11월 운영 점검에서는 운영 서버의 블루·그린이 같은 쓰기 DB를 사용하고, 다른 서버에 대기 앱, 읽기 전용 DB 복제본, 백업 사본이 있는 것을 확인했습니다. 대기 앱은 자체 DB로 검증할 수 있게 구성돼 있었습니다. 운영 변경을 받아 오는 복제본과는 분리돼 있어, 대기 앱이 응답한다는 사실만으로 운영 데이터를 읽고 쓸 수 있다고 판단할 수는 없었습니다.
점검 시점에는 복제본이 운영 DB의 변경을 받아 적용하고 있었고, MySQL이 표시한 지연은 0초였습니다. 비동기 복제에서는 운영 DB가 저장을 확인한 변경이 복제본에 아직 도착하지 않았을 수 있습니다. 한 번의 지연 수치로 장애 시 데이터 손실량을 정할 수 없는 이유입니다. 쓰기를 넘기려면 이전 DB가 다시 쓰지 못하도록 막고, 복제본이 어디까지 적용했는지 확인한 뒤 새 쓰기 대상으로 지정해야 합니다. MySQL 복제 문서
백업 사본을 다시 여는 정기 시험은 격리 환경에서 약 99초에 통과했습니다. 다른 리허설에서는 장애를 선언한 뒤 기존 쓰기 차단, 백업 복원, 앱 기동, 내부 접속 전환을 거쳐 새 쓰기가 성공하기까지 32.82초를 기록했습니다. 두 수치는 서로 다른 시험에서 나왔습니다. 첫 시험은 사본을 복원할 수 있는지, 두 번째는 같은 호스트의 한 MySQL 안에서 리허설용 DB 공간을 나눠 전환 절차가 끝까지 이어지는지 확인했습니다. 실제 운영 서버를 잃은 상황에서 공개 주소와 쓰기를 복구하는 시간은 측정하지 않았습니다. 얼쑤의 DB 쓰기 전환 검증
Kubernetes로 옮겼을 때 달라지는 범위
Kubernetes의 Deployment는 선언한 수의 앱 인스턴스를 유지하고 버전을 점진적으로 바꿉니다. 다른 호스트에 여유 용량이 있고 그곳에서 이미지와 설정을 가져올 수 있다면, 호스트가 사라진 뒤 앱을 다시 배치하는 데에도 도움이 됩니다. 팀이 여러 서비스를 여러 호스트에 반복해서 배치하거나 인스턴스 수를 자주 조절해야 한다면 직접 작성한 배포 도구의 부담을 줄일 수 있는 부분입니다. Kubernetes Deployment 문서
앱을 옮길 새 호스트와 클러스터를 관리하는 기능이 살아 있어야 한다는 조건도 있습니다. 두 대로 시험할 때는 한 대에 관리 기능을 두고 다른 한 대를 실행 노드로 쓰는 안을 검토했습니다. 관리 서버가 멈추면 이미 실행 중인 앱은 남아 있을 수 있지만 새 배치와 클러스터 차원의 자동 복구는 진행할 수 없습니다. K3s의 내장 etcd는 클러스터 상태를 기록할 때 과반수 동의를 요구합니다. 두 멤버 중 한 대를 잃으면 남은 한 대로는 과반수를 만들 수 없습니다. 그래서 이 방식의 고가용성 구성은 관리 서버를 최소 3대 둡니다. 외부 저장소를 쓰면 관리 서버 2대도 가능하지만, 이번 조건에서 그 저장소까지 장애를 견디게 할 구성은 확인하지 못했습니다. 운영 앱이 쓰는 DB와 클러스터 설정을 저장하는 DB도 역할이 다릅니다. K3s 내장 etcd 구성 · K3s 외부 DB 구성
당시 검토에서는 평소 배포 중단부터 줄이는 데 Compose를 확장하는 방식을 우선 권고했습니다. 기존 배포 경로에 새 인스턴스 준비와 요청 전환을 추가하는 것으로 당장의 문제를 다룰 수 있었기 때문입니다. K3s로 옮기면 여러 서버의 앱 배치는 선언으로 관리할 수 있지만, 이미지 전달과 클러스터 상태 저장소를 함께 운영해야 합니다. 접속 주소와 DB 쓰기 경로의 전환은 두 안에서 공통으로 남습니다. 이후 운영에서 확인한 것은 Compose로 실행한 블루그린 배포와 복구 준비였습니다.
다음 도구를 고르기 전에 시험할 것
다음 리허설을 설계한다면 접속과 쓰기가 실제로 함께 돌아오는지를 시험 기준으로 삼을 수 있습니다.
- 격리 환경에서 시각과 식별자를 붙인 쓰기를 남기고, 정상 응답을 받은 항목을 기록합니다.
- 운영 역할의 서버를 끊은 시점부터 시간을 잽니다. 시험용 사용자 주소로 다시 접속해 이전 데이터 읽기, 새 쓰기, 기존 파일 접근이 성공하는 시각을 각각 기록합니다.
- 마지막으로 복구된 쓰기를 처음의 기록과 대조합니다. 원래 서버가 돌아왔을 때도 한 DB만 쓰기를 받는지 확인합니다.
팀이 서비스가 멈춰도 되는 시간(RTO, 복구 시간 목표)과 잃어도 되는 데이터의 시간 범위(RPO, 복구 지점 목표)를 정하면, 시험에서 잰 값을 그 기준과 비교할 수 있습니다. 앱을 다른 곳에 띄우는 데 시간이 걸리면 자동 배치를 비교할 이유가 생깁니다. 앱이 떠도 같은 주소에서 접근하거나 쓰기를 재개하는 데 시간이 걸린다면, 접속 전환이나 DB 복구가 먼저 다룰 대상입니다.
댓글
댓글과 반응은 GitHub 계정으로 로그인해 남길 수 있어요.