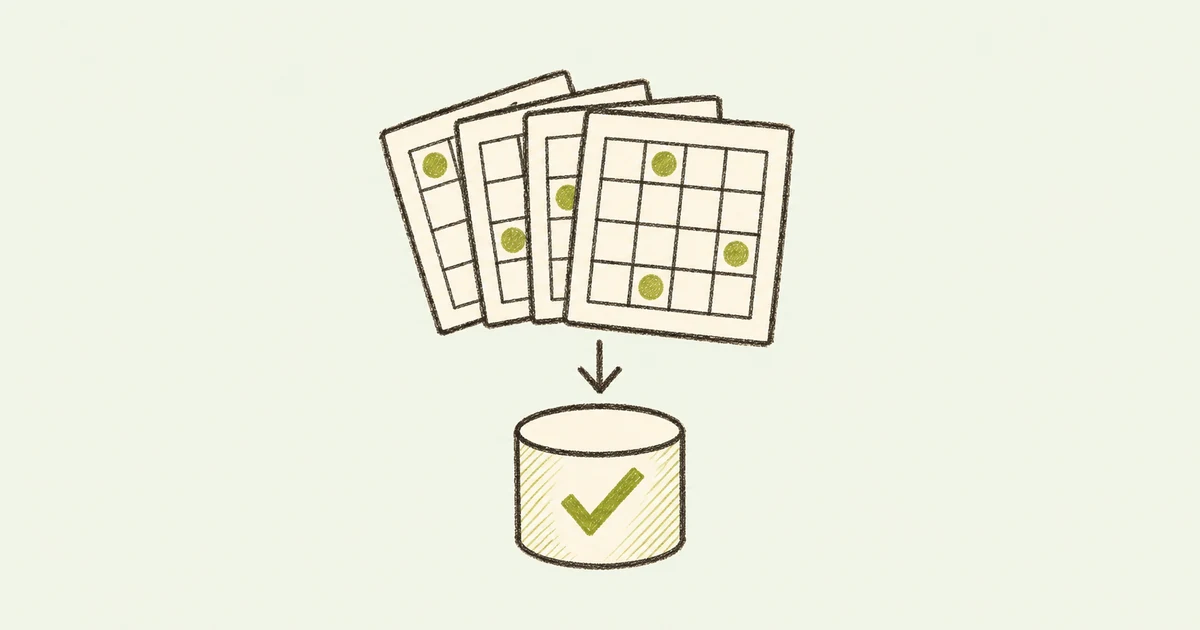
얼쑤에서 단소 연습 세션을 시작하려면 DB에 채점 가능한 곡이 있어야 합니다. 처음 적용할 때는 곡 테이블이 비어 있어 선택할 대상이 없었습니다. 데이터팀이 검토한 정간보 네 곡을 공통 악보 JSON으로 변환하고, DB에 처음 넣는 데이터인 시드에 담았습니다. 곡 네 개가 조회되는 것과 그 안의 음표·쉼표·시간이 원본에서 그대로 넘어오는 것은 다른 확인이었습니다.
원본과 변환 결과 대조
시드 SQL 머리말에 변환기의 버전, 원본과 변환 코드의 기준 시점, 입력 파일의 SHA-256을 남겼습니다. 시간이 지나도 어떤 파일로 시드를 만들었는지 대조할 수 있어야 검사를 다시 실행할 수 있습니다. 서비스에서 곡을 게시 상태로 넣기로 한 결정도 함께 기록했습니다. 그 값은 원본 악보에서 읽어 낸 값과 구분했습니다.
검사기는 저장소의 시드 SQL에 들어 있는 값과, 정답 악보 파일을 다시 변환한 결과를 읽습니다. 이때 임시 SQLite는 INSERT에 적힌 값을 읽어 오는 용도로만 씁니다. 두 JSON을 객체로 파싱해 공백과 객체의 키 순서 차이를 걷어 내고, 배열 순서와 값까지 비교했습니다. 아리랑은 앞서 검토한 고정 자료가 있어 들여쓰기를 포함한 JSON의 바이트도 따로 맞춰 봤습니다.
검사기에는 프로젝트 환경과 분리해 실행하는 방법을 적어 뒀습니다. 저장소 루트에서 uv run --no-project --with jsonschema python data/src/scores/verify_danso_seed.py를 실행하면 검사기에 필요한 jsonschema를 그 실행에만 추가할 수 있습니다. 프로젝트의 의존성 선언을 수정하는 대신, 시드 파일을 읽고 검사하는 환경을 따로 구성했습니다. uv의 스크립트 실행 문서
원본 율명과 박자 별도 검사
시드를 만들 때와 확인할 때 같은 변환기를 쓰므로, 두 JSON이 같아도 변환기 자체의 같은 오류가 남을 수 있습니다. 그래서 필수 필드와 자료형은 JSON Schema로 확인하고, 원본에 표시된 율명은 별도로 읽어 새 음이 시작되는 순서와 대조했습니다. 이어지는 음과 빈 정간을 새 음으로 세지 않았는지, 이벤트마다 길이가 양수인지, 앞 이벤트의 끝과 뒤 이벤트의 시작이 이어지는지, 총 박이 정간 수와 정간당 박으로 계산한 값과 같은지도 확인했습니다.
| 확인한 곡 | 새 음 시작 | 쉼 | 정간 | 숨표 |
|---|---|---|---|---|
| 아리랑 | 61 | 4 | 48 | 4 |
| 도라지타령 | 91 | 3 | 84 | 11 |
| 밀양아리랑 | 85 | 0 | 48 | 0 |
| 늴리리야 | 68 | 4 | 72 | 2 |
| 합계 | 305 | 11 | 252 | 17 |
네 곡 모두 시드와 재변환 JSON의 전체 필드가 일치했고, 별도로 읽은 율명·옥타브 순서와 시간 규칙도 맞았습니다. 아리랑 한 곡은 고정 자료와 바이트까지 일치했습니다. 이 시작 틱을 채점기에 전달했을 때의 검증은 쉼표 글에서 다뤘습니다. 쉼표가 바꾼 아리랑 음표 45개의 시작 박
음표 수를 바꿔 실패 확인
시드 사본에서 아리랑의 악보 JSON은 그대로 두고 곡에 따로 기록한 음표 수만 61에서 62로 바꿨습니다. 검사기는 음표 수가 맞지 않는다는 단언 오류로 멈췄고 종료 코드는 1이었습니다. 원래 시드의 검사는 종료 코드 0이었습니다. 이 대조로 JSON 본문을 제대로 옮겨도 함께 저장하는 곡의 요약 값이 어긋날 수 있다는 점을 검사에 포함했습니다.
여기서 대조한 대상은 운영에 적용했던 저장소의 시드 파일입니다. 현재 운영 DB의 행을 다시 읽은 검수와는 범위가 다릅니다. 정간보 해석은 데이터팀이 검토한 입력을 기준으로 삼았으며, 네 곡에 없는 시김새는 이 사례로 확인할 수 없습니다.
댓글
댓글과 반응은 GitHub 계정으로 로그인해 남길 수 있어요.